¿Es el contexto el futuro del CRM?
El futuro del CRM con IA no está en la pantalla sino en el contexto: una base que ajusta sus propios campos y los convierte en métricas, KPIs y OKRs fiables.
En el mundo SaaS, elegir CRM ha seguido durante años un guion bastante previsible. Las startups empezaban con HubSpot y, cuando crecían, la regla no escrita era migrar a Salesforce al acercarse a los 40 millones de ARR. Había alternativas, de Microsoft Dynamics a recién llegados como Attio, pero el guion era ese.
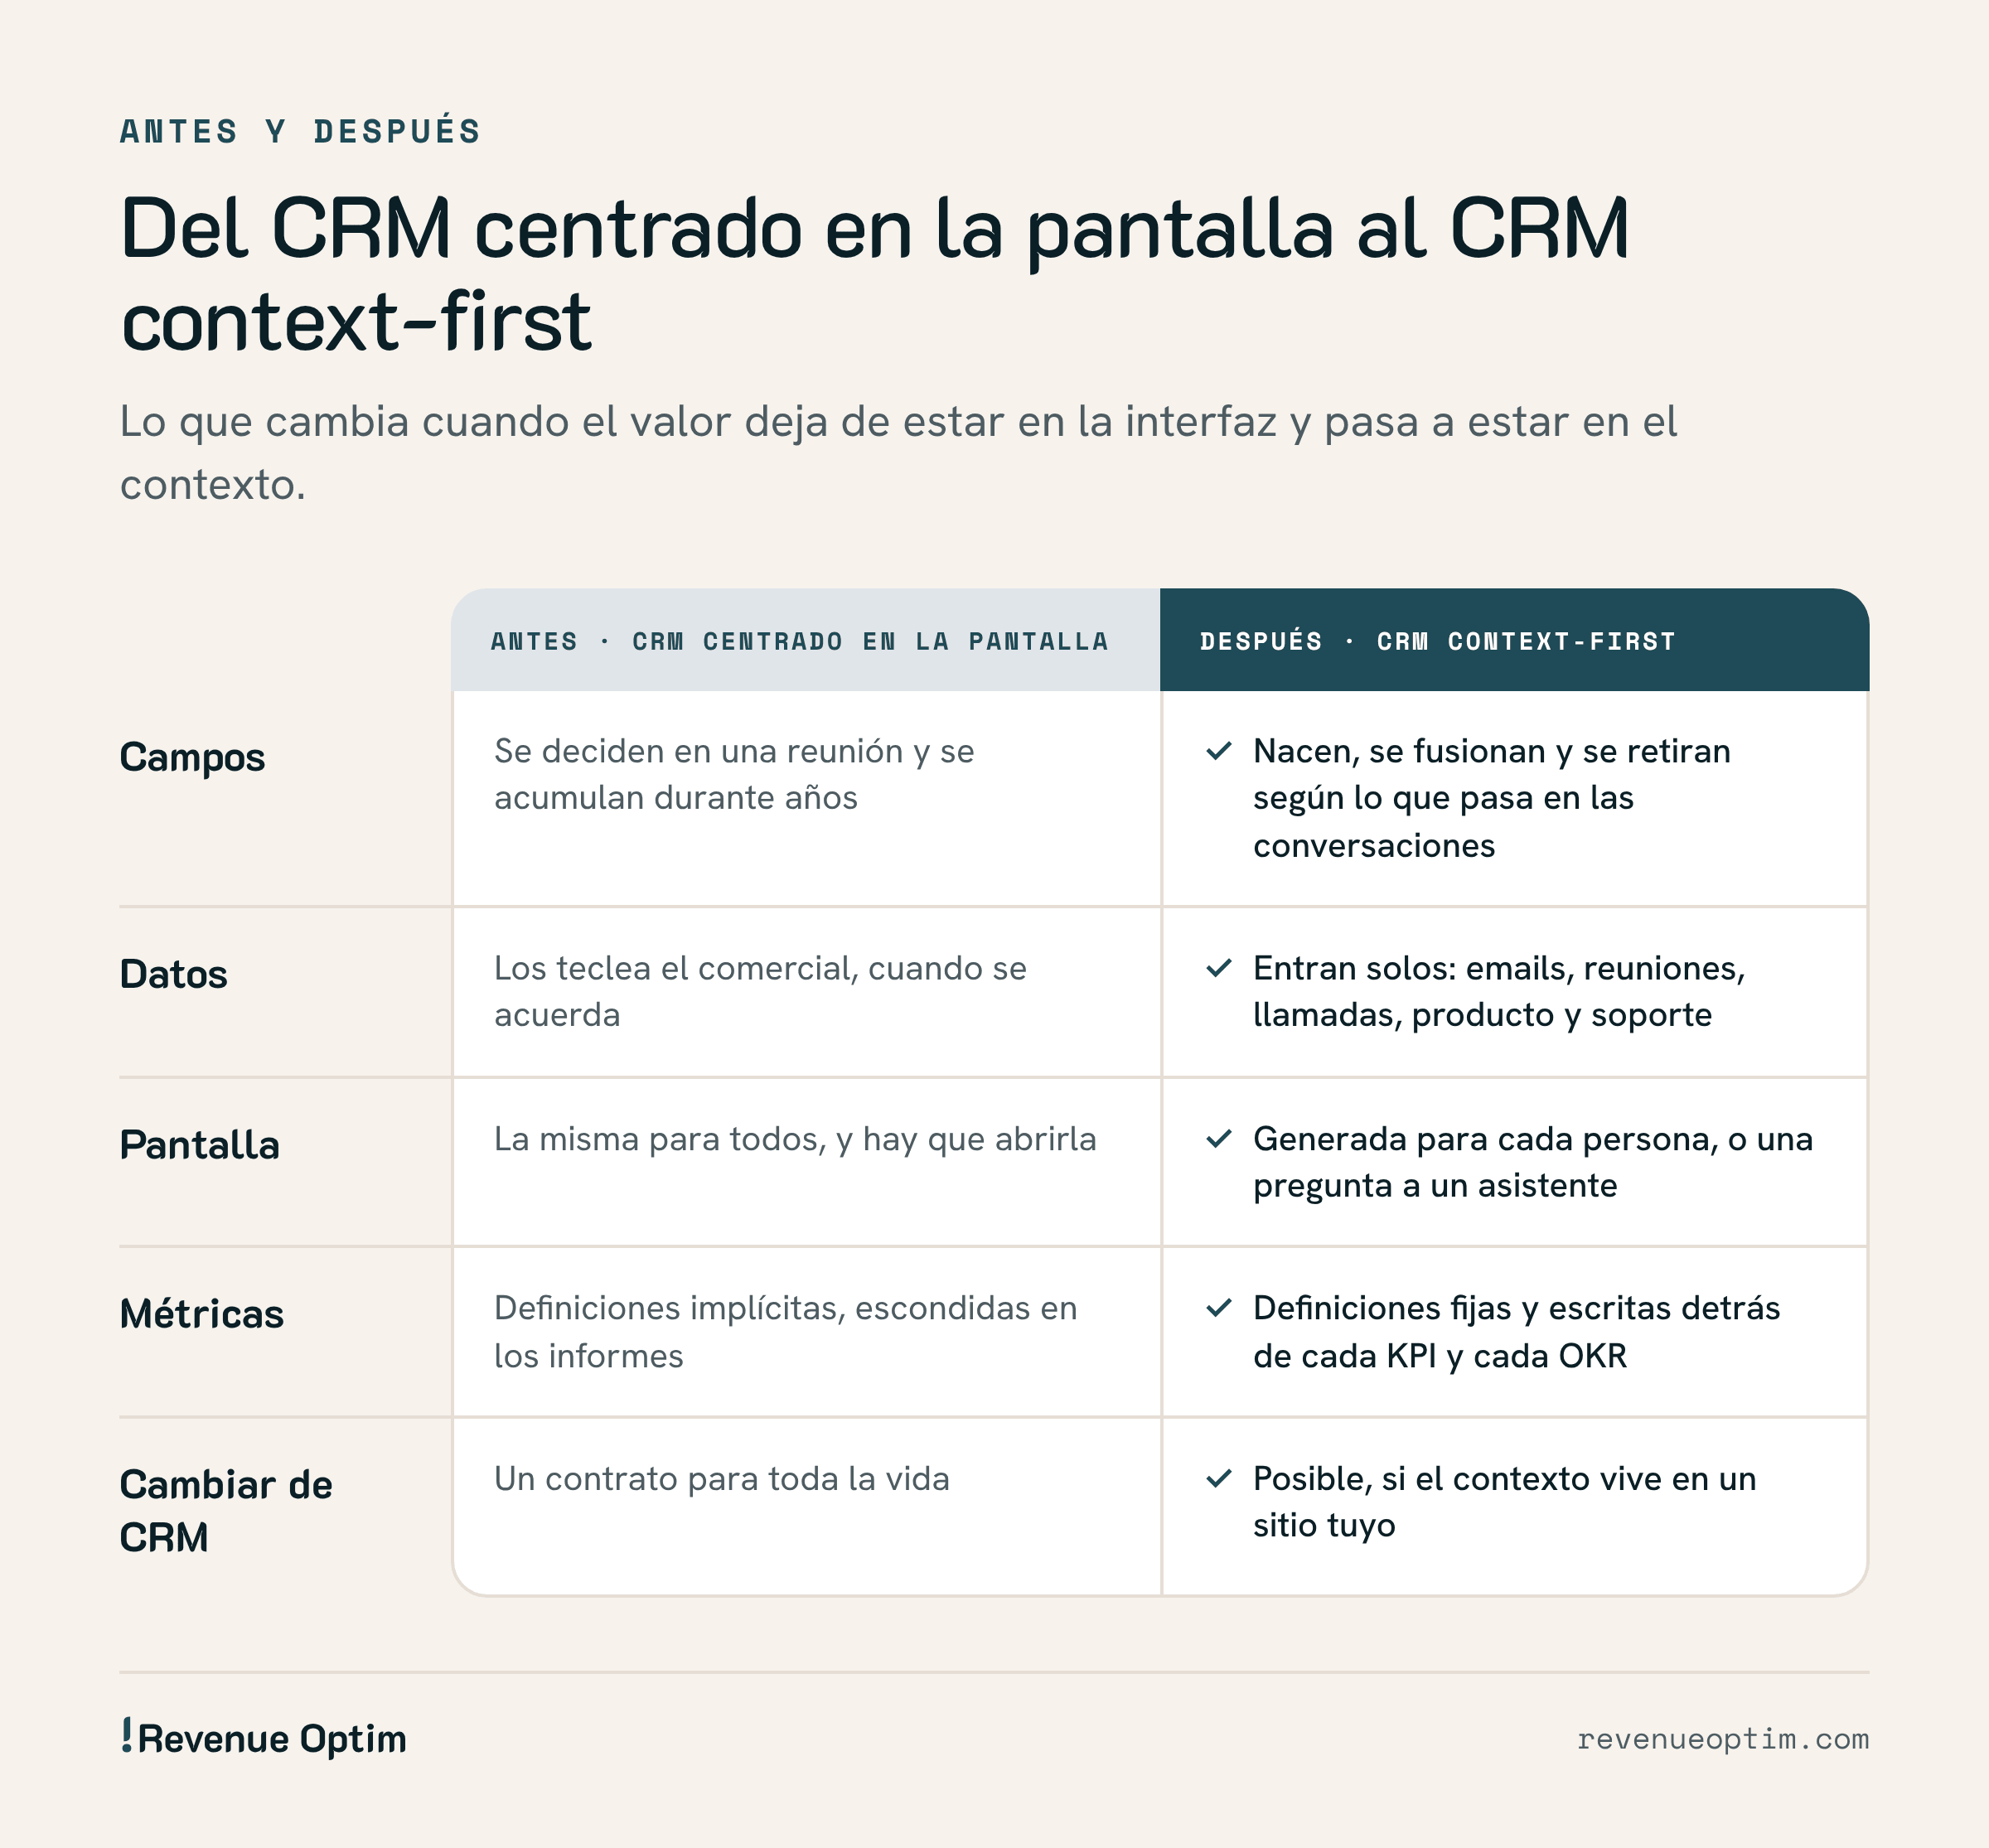
Y había algo que todo el mundo sabía: el CRM era un contrato para toda la vida. Una vez dentro, la cantidad de datos, campos, automatizaciones e informes acumulados hacía que migrar fuera caro, lento y arriesgado. Se cambiaba de CRM una vez, como mucho, y con miedo.
Ese guion tiene los días contados. Si un asistente te dice qué tienes pendiente con cada cuenta, ya no abres el CRM. Si los emails, las reuniones y las llamadas entran solos, ya nadie teclea en él. Y si la IA puede leer un modelo de datos y trasladarlo a otro, migrar deja de ser una pesadilla. Los fabricantes que sigan puliendo la pantalla estarán puliendo justo lo que va a desaparecer. El futuro del CRM es otra cosa: una base de datos que entiende lo que guarda, que crea y ajusta sus propios campos, y que convierte todo eso en las métricas con las que se dirige una empresa. Un CRM context-first.
Para qué servía el CRM hasta ahora
Si lo piensas, el CRM siempre ha hecho tres trabajos a la vez. Es el registro, el sitio donde consta qué cuentas tienes, de quién es cada una y qué se ha firmado. Es el lugar de trabajo del comercial, con sus tareas, sus notas y su siguiente paso. Y es de donde sale el informe de los lunes y el forecast que mira dirección.
La guerra entre fabricantes se ha librado casi siempre en el segundo trabajo: qué pantalla es más cómoda, qué automatizaciones trae de serie, qué informe puedes montar sin llamar a nadie. Y ahí mismo vivía la queja eterna de los comerciales, que es bastante justa: el CRM te pide mucho y te devuelve poco.
Lo que la IA le quita al CRM
La IA le quita al CRM dos de esos tres trabajos, o por lo menos se los cambia de sitio.
El primero es la pantalla. Si puedo preguntarle a un asistente qué tengo pendiente con una cuenta y me contesta con todo cruzado, ¿para qué voy a abrir el CRM? El trabajo del día pasa a ser una conversación, y las pantallas que hagan falta se generarán al momento, a la medida de quien pregunta.
El segundo es meter datos. Los emails, las reuniones, las llamadas, el uso del producto y los tickets de soporte ya pueden llegar al CRM sin que nadie los teclee. Lo que antes dependía de que el comercial fuera disciplinado ahora depende de que alguien haya conectado bien las cosas.
Lo que queda es el registro: unas cuantas tablas con cuentas, contactos, oportunidades y actividades. Una base de datos, vaya. Y justo ahí empieza el problema.
Por qué una base de datos no basta
Una base de datos te dice qué pasó. Un agente, para ayudarte de verdad, necesita saber por qué pasó y qué quiere decir. Se entiende mejor con un caso.
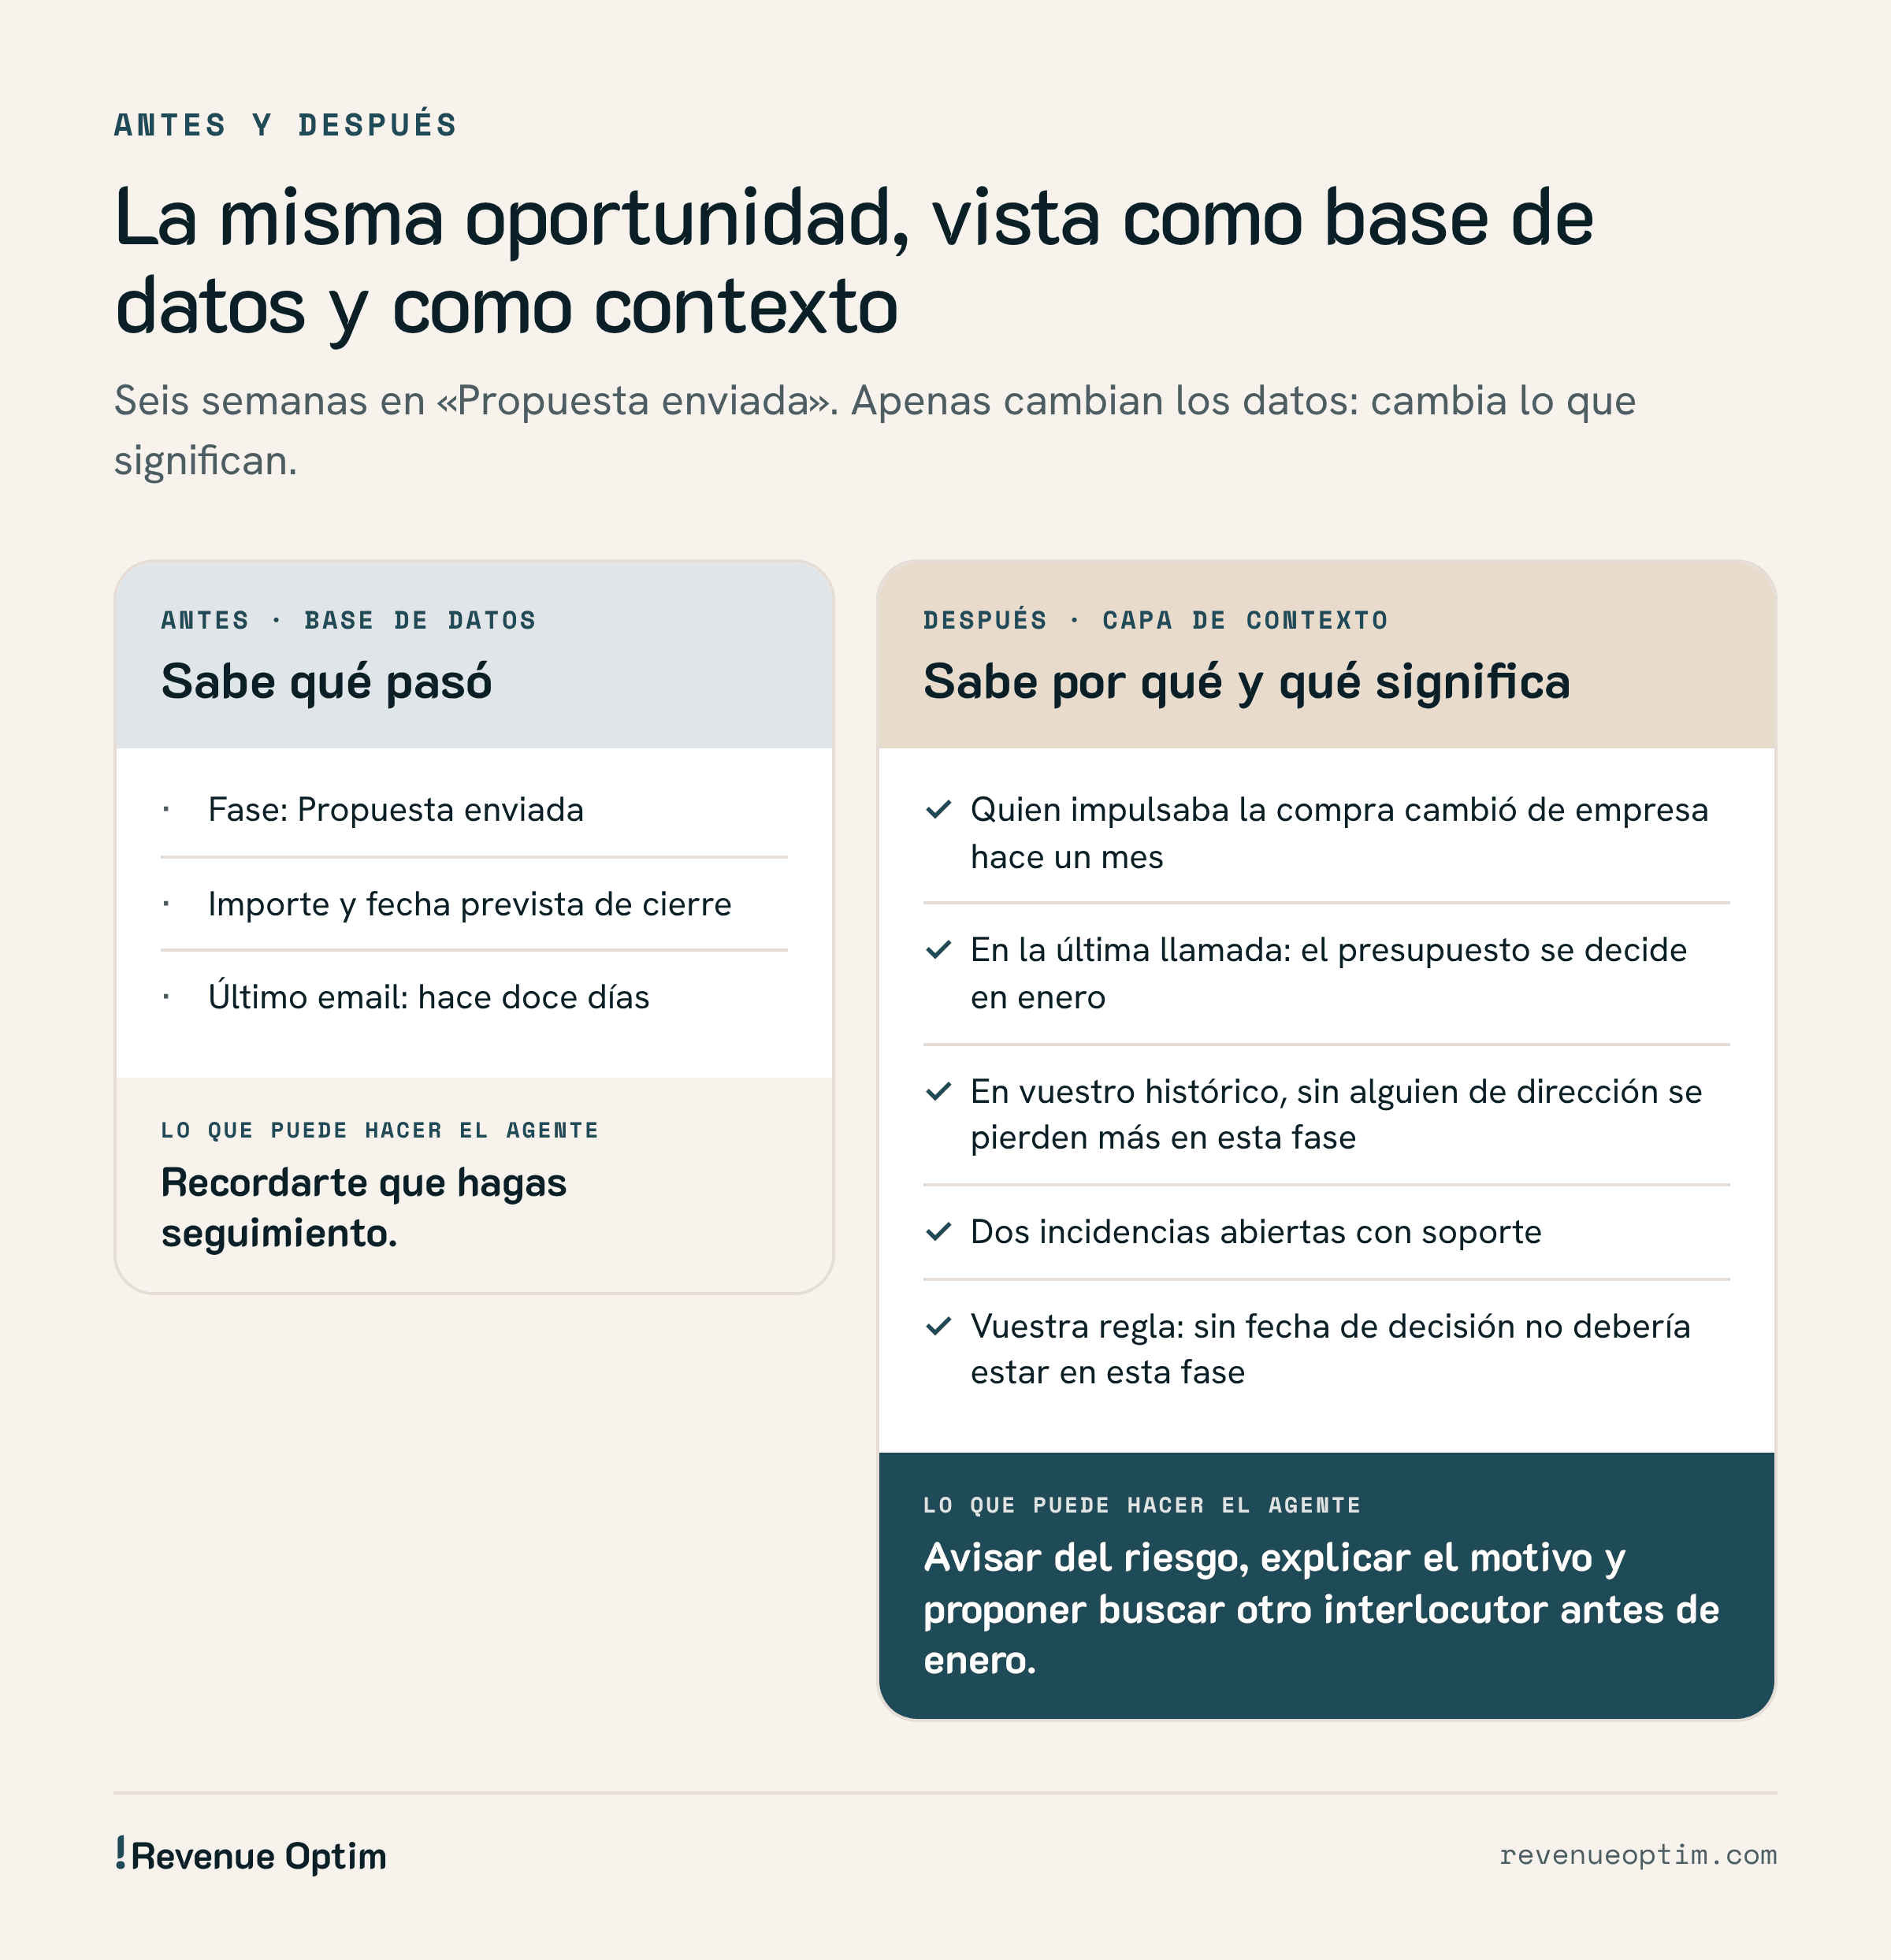
Piensa en una oportunidad que lleva seis semanas en "Propuesta enviada". La base de datos sabe eso, el importe, la fecha prevista de cierre y que el último email salió hace doce días. Con eso, lo más que puede hacer un agente es recordarte que hagas seguimiento. Gracias, ya lo sabías.
Ahora imagina que el sistema sabe algo más. Que la persona que empujaba la compra se fue a otra empresa hace un mes. Que en la última llamada el cliente dijo que el presupuesto se decide en enero. Que en vuestro histórico las oportunidades sin nadie de dirección dentro suelen morir justo en esta fase. Que la cuenta tiene dos incidencias abiertas con soporte. Y que, según vuestra propia regla, una propuesta sin fecha de decisión acordada ni siquiera debería estar ahí.
Con eso el agente ya puede decirte algo útil: esta oportunidad está en riesgo, por estos motivos, y lo sensato es buscar otro interlocutor antes de enero. Fíjate en que apenas hemos añadido datos. Lo que hemos añadido es significado, y esa es toda la diferencia entre una base de datos y una capa de contexto.
Cómo será el CRM del futuro: context-first
Hoy los campos de un CRM se deciden en una reunión. Alguien pide uno nuevo, otro lo crea, y tres años después hay cuatrocientos, la mitad vacíos y unos cuantos que significan lo mismo con nombres distintos. El modelo de datos se queda congelado en lo que alguien imaginó un día, mientras el negocio sigue cambiando.
Un CRM context-first le da la vuelta a eso. El modelo de datos deja de ser una estructura fija y pasa a ser algo vivo, que se adapta a lo que de verdad ocurre en las conversaciones con clientes. Imagina un CRM que hace cosas como estas:
Detecta que en las llamadas de las últimas semanas sale una y otra vez la misma objeción sobre seguridad, propone un campo para recogerla y lo rellena hacia atrás leyendo las transcripciones que ya tiene. Se da cuenta de que "Sector" y "Industria" son el mismo dato escrito de dos formas y te propone fusionarlos. Te avisa de que un campo que nadie ha tocado en un año se puede retirar. Y, mirando el histórico, te dice que uno de tus criterios de fase no predice nada, porque las oportunidades que lo cumplen se cierran igual que las que no.
Encima de esa base, la pantalla deja de ser un producto. Cada persona ve lo que necesita, generado para ella: un director comercial ve el forecast con sus riesgos explicados, un comercial ve sus cuentas del día con el motivo de cada una, y alguien de customer success ve qué clientes tienen señales de irse. Es la misma base contada de tres maneras.
Esto no es para dentro de diez años. Las piezas, desde modelos que leen transcripciones hasta asistentes que consultan varias herramientas a la vez, existen ya. Lo que falta es un CRM diseñado alrededor de ellas, en lugar de uno que las añade como un botón más.
Lo que tiene que estar debajo
Guille ya lo apuntaba en GTM engineering 2.0 ya está aquí: quien tenga el contexto decide qué hacen todos los demás sistemas. No es magia ni un producto que se compra. Debajo de un CRM context-first hay cinco cosas que cualquiera que haya trabajado en RevOps reconocerá.
La primera es que cada cuenta sea una sola ficha. Parece obvio, pero es habitual que la misma empresa exista tres veces, en el CRM, en facturación y en soporte, cada una con un nombre ligeramente distinto.
La segunda es guardar la historia y no solo el último valor. Saber que una oportunidad está en negociación sirve de poco si no sabes cuándo llegó ahí ni cuántas veces ha ido para atrás.
La tercera son las definiciones escritas: qué es un lead cualificado, qué tiene que pasar para cambiar de fase, qué cuenta encaja con el ICP. Si eso no está escrito donde un agente pueda leerlo, cada agente se montará su propia versión, y ninguna será la vuestra.
La cuarta es el porqué: motivos de pérdida, objeciones, decisiones y sus razones. Es lo que permite aprender, y es lo que peor guardan casi todos los CRM que vemos.
Y la quinta es tener claro qué sistema manda cuando dos dicen cosas distintas, y qué puede tocar un agente sin pedir permiso.
Lo que no cambia: datos que se convierten en métricas, historias, KPIs y OKRs
Aquí está el riesgo de todo lo anterior. Un CRM que crea y edita sus propios campos puede ser una maravilla o puede ser la forma más rápida de pudrir tus datos. Si los campos cambian solos, el KPI que mirabas en marzo puede no medir lo mismo en septiembre, y nadie se habrá enterado.
Por eso la base no cambia. Un CRM existe, al final, para que los datos se conviertan en métricas, las métricas en KPIs y los KPIs en OKRs con los que se dirige la empresa. Lo que sí cambia es que, con contexto, el CRM puede contar además la historia detrás del número: no solo que la conversión de propuesta a cierre ha bajado, sino que ha bajado en las cuentas donde cambió el interlocutor, y desde cuándo.
Un CRM context-first, si está bien hecho, tiene dos capas que se comportan distinto. Una se adapta sola: los campos que recogen lo que pasa en las conversaciones, que pueden nacer, fusionarse y retirarse. La otra solo cambia cuando alguien lo decide: las definiciones que hay detrás de cada métrica, cada KPI y cada OKR. La primera da flexibilidad. La segunda da confianza. Sin la segunda, la primera es ruido.
¿Y el criterio? También se puede recoger, con condiciones
Hay quien dirá que la actividad se recoge sola pero el criterio no. Yo creo que eso ya no es del todo verdad.
Con herramientas de notas de reuniones como Granola, que usamos en nuestras propias llamadas de descubrimiento, lo que un equipo discute ya no se pierde. Cuando el equipo comercial se sienta a revisar por qué se perdió un trato o si una cuenta merece la pena, esa conversación queda transcrita y resumida. Si después hay un flujo ordenado que lleva la conclusión a la ficha correcta del CRM, el porqué entra en el sistema sin que nadie tenga que rellenar un campo. Hace no tanto, eso dependía de que alguien tomara buenas notas y encima tuviera ganas de pasarlas al CRM.
Eso sí, para que funcione tienen que pasar cuatro cosas, y ninguna la hace la herramienta. Tiene que haber reunión, porque si nadie revisa las oportunidades perdidas no hay nada que transcribir. La reunión tiene que acabar en una decisión, porque una transcripción guarda las tres opiniones que salieron y al CRM le hace falta la conclusión. Alguien tiene que haber diseñado el flujo: qué se saca de cada reunión, a qué ficha va y qué pasa si contradice lo que ya había. Y lo que se decide tiene que acabar convertido en regla. Si el equipo acuerda un martes que una propuesta sin fecha de decisión no cuenta como propuesta, eso tiene que quedar como criterio de fase, no perdido en las notas de ese martes.
O sea, el criterio puede llegar al CRM casi solo, pero el camino por el que llega hay que construirlo. Por eso no creo que la IA le quite trabajo a RevOps. Se lo cambia: menos perseguir a comerciales para que rellenen campos y más diseñar reuniones, flujos, definiciones y reglas. En un CRM context-first, RevOps es quien cuida la capa que no debe cambiar sola. Y si marketing y ventas todavía no se han puesto de acuerdo en lo básico, lo primero es un SLA entre marketing y ventas.
Del contrato para toda la vida al contexto que es tuyo
Si migrar ya no da tanto miedo, ¿se acaba el contrato para toda la vida? No del todo. Cambia de sitio.
Hasta ahora lo que te ataba al CRM era el volumen: años de registros, cientos de campos y automatizaciones que nadie se atrevía a tocar. Con IA, mover registros y emparejar campos de un sistema a otro es cada vez más trabajo de máquina. Lo que no se mueve tan fácil es el contexto: las definiciones, la historia, el porqué de cada decisión y las reglas que hay detrás de cada métrica. Si todo eso vive solo dentro del CRM, en el formato del fabricante, el contrato para toda la vida vuelve, y más fuerte que antes.
Así que la pregunta útil ya no es solo qué CRM elegir. Es dónde vive tu contexto y si es tuyo. Las definiciones de tus fases, de tu ICP y de tus KPIs deberían estar escritas en un sitio que controlas y que se puede llevar a cualquier sistema. Ese es el seguro que te deja cambiar de CRM cuando te convenga, y no cuando te deje el fabricante.
Qué les pasa a HubSpot, Salesforce y al resto de CRM
Para quien vende CRM, todo esto plantea una pregunta incómoda: si el valor ya no está en la pantalla, ¿dónde está? Yo veo tres salidas y, sinceramente, no sé cuál va a ganar.
Puede que los CRM de siempre se reinventen como context-first. Los grandes ya están metiendo asistentes y conexiones para agentes, y si consiguen que su modelo de datos se vuelva vivo, seguirán en el centro. Puede que el CRM se quede como base de datos y el contexto se construya en otra capa por encima, que lea del CRM y de todo lo demás. Y puede que aparezcan CRM nacidos context-first, pensados desde cero para que los usen agentes y no personas.
Lo que sí tengo claro es qué le diría hoy a una empresa que está eligiendo CRM: no elijas por la pantalla. Pregunta otras cosas. Si es fácil sacar y meter datos. Si guarda el historial de cambios o solo el último valor. Si puedes guardar definiciones y motivos con estructura, y no en un campo de texto libre. Si puedes conectar agentes con permisos claros. Si, cuando el sistema cambia un campo, queda registrado quién lo cambió y por qué. Y si el día que quieras irte podrás llevarte no solo los registros, sino también el contexto. Esas respuestas van a pesar más que la demo.
Qué puedes hacer con tu CRM este trimestre
No hace falta esperar a ver quién gana. Casi todo lo que prepara un CRM para ser context-first se puede empezar ya, con el CRM que tienes:
- Escribe una frase por fase que diga qué tiene que ser verdad para pasar a la siguiente.
- Haz obligatorio el motivo de pérdida, y que se elija de una lista cerrada. El texto libre no hay quien lo analice después.
- Quita los duplicados y decide qué sistema manda para cada dato.
- Haz inventario de campos: cuáles se usan, cuáles significan lo mismo y cuáles sobran.
- Cuelga de la misma ficha todo lo que sabes de la cuenta: emails, reuniones, llamadas, producto y soporte.
- Asegúrate de que el CRM guarda cuándo cambió cada fase y quién la cambió.
- Escribe la definición de cada métrica que miras, de cada KPI y de cada OKR, y qué campos usa, en un sitio que sea tuyo y no dependa del CRM. Si tu ICP está parcialmente identificado y no documentado, empieza por calcular tu ICP real.
- Pon una reunión fija para revisar lo ganado y lo perdido, grábala y define cómo llegan sus conclusiones al CRM.
Si no tienes claro en qué estado está tu CRM, repasa las señales de que necesita una auditoría. Y si prefieres que le echemos un ojo juntos, para eso está el Diagnóstico RevOps y GTM: revisamos el proceso comercial y el sistema que lo sostiene, y te decimos por dónde empezar. El trabajo en sí lo hacen nuestros proyectos de CRM, datos y forecasting.
Preguntas frecuentes
¿Cuál es el futuro del CRM?
El contexto. Con la IA, la pantalla pierde valor y los datos entran solos, así que el CRM que importe será el que entienda lo que guarda: con su historia, sus definiciones y su porqué, y capaz de convertirlo en métricas, KPIs y OKRs fiables. Es lo que llamamos un CRM context-first.
¿Qué es un CRM context-first?
Es un CRM diseñado alrededor del contexto y no de la pantalla. Su modelo de datos se adapta a lo que pasa en las conversaciones con clientes, creando, fusionando y retirando campos, mientras mantiene fijas las definiciones que hay detrás de cada métrica. La pantalla se genera encima, a la medida de quien la usa.
¿Va a desaparecer el CRM?
No. Lo que pierde peso es la pantalla. El registro sigue haciendo falta, y con agentes trabajando encima importa todavía más, porque nadie va a ver a simple vista que un dato está mal.
Si los campos se crean solos, ¿cómo sé que mis KPIs siguen midiendo lo mismo?
Separando dos capas. Los campos que recogen lo que pasa pueden cambiar solos. Las definiciones de tus métricas, KPIs y OKRs solo cambian cuando alguien lo decide, y cada cambio queda registrado. Sin esa separación, un CRM que se adapta solo acaba siendo un CRM en el que nadie confía.
Si los datos se recogen solos, ¿para qué hace falta RevOps?
Porque alguien tiene que construir el camino y cuidar lo que no debe cambiar. Herramientas como Granola recogen lo que el equipo habla, pero alguien decide qué reuniones hay, qué se saca de ellas, a dónde va y cuándo una conclusión pasa a ser regla. Ese trabajo no desaparece, crece.
¿Será más fácil cambiar de CRM?
Mover registros y campos, sí: cada vez es más trabajo de máquina. Lo que seguirá atándote es el contexto, si vive solo dentro del CRM. Si tus definiciones, tu historia y tus reglas están escritas en un sitio tuyo, el CRM deja de ser un contrato para toda la vida.
¿Tengo que cambiar de CRM para prepararme?
Casi nunca como primer paso. Las fases, los motivos de pérdida, las cuentas unificadas, el inventario de campos y las definiciones de tus métricas se trabajan en el CRM que ya tienes. Si luego hace falta cambiar, al menos sabrás qué estás buscando.
¿Quieres ir más al detalle?
Descarga el playbook RevOps y llévate el marco completo por escrito.